Comment passer du chatbot à l'IA agentique sans exploser sa facture de tokens ?
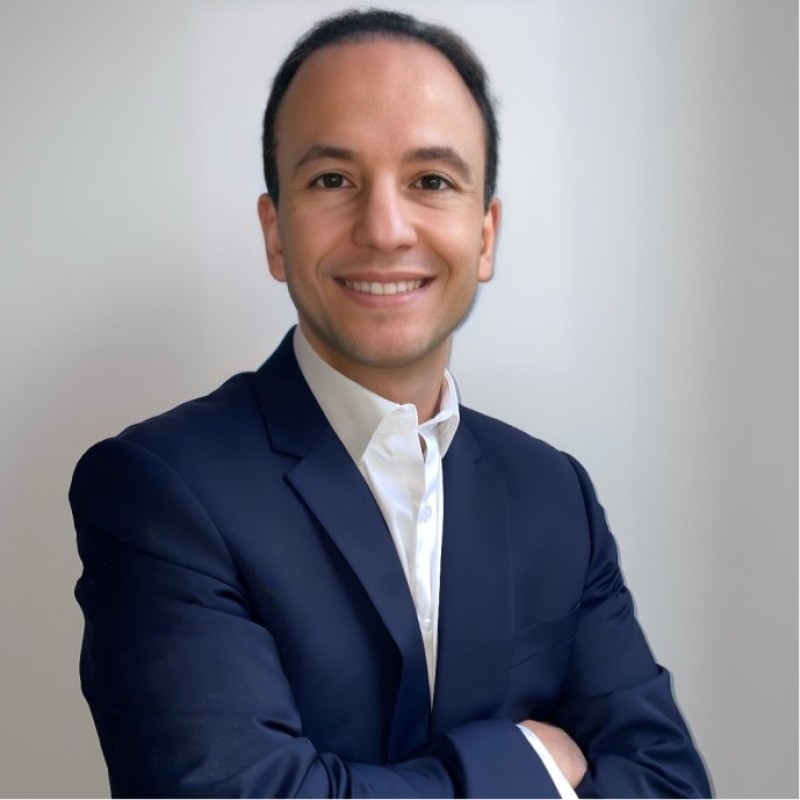

Fouad Maach est directeur de l'architecture et de l'ingénierie au sein de la DSI Groupe de Veolia. Déjà très engagée dans l’IA avec la mise en place de la plateforme Veolia Secure GPT en septembre 2023, l’entreprise s’attache désormais à optimiser sa consommation de tokens. Passer d’un usage centré sur le chatbot au déploiement de plus de 2 000 agents IA a des répercussions financières importantes. Lors de la matinale FinOps du 8 octobre 2026, Fouad a présenté les moyens mis en œuvre pour garder la maîtrise des coûts liés aux usages de l’IA.
Quels ont été les déclencheurs de cette démarche FinOps sur l’IA ?
Le 5 septembre 2023, nous avons lancé notre plateforme Veolia Secure GPT. Nous comptons aujourd’hui près de 100 000 utilisateurs actifs, 350 000 sessions par mois et plus de 2 100 agents IA déployés en production dans l’ensemble des 43 filiales du Groupe. Il est important d'avoir en tête que le passage du chatbot à l’ère agentique représente un véritable défi d'un point de vue FinOps : sans mesures adaptées, le nombre de tokens consommés à chaque interaction peut être multiplié par un facteur de 50 à 1 000 !
Même si le coût par token a drastiquement diminué entre 2023 et 2026, le nombre de tokens utilisés a augmenté beaucoup plus vite que leur prix n’a baissé. Pourtant, malgré cette transition du chatbot à l'agentique, l’utilisation de Veolia Secure GPT ne représente aujourd'hui qu’un peu moins de 0,2 % du budget IT global de Veolia.
Quelles mesures avez-vous prises pour maintenir le cap financier ?
Plusieurs leviers ont été mis en place pour maximiser la valeur apportée par l’IA tout en minimisant la facture.
En premier lieu, nous avons déployé une AI Gateway par laquelle passent absolument tous les appels à destination de plus de 80 LLM du marché, dont évidemment Claude, GPT et Gemini, mais également Mistral, Meta, DeepSeek, Cohere, etc. Ces appels peuvent provenir de Veolia Chat, de notre plateforme Secure GPT et de nos agents IA, mais également de nos applications via des API, ou encore d’applications SaaS telles que Copilot ou Agentforce. Chaque token ne peut sortir du SI de Veolia qu’une fois que notre AI Gateway a validé, entre autres, le respect des quotas par utilisateur ou par application, celui des quotas financiers mensuels et le routage des appels. Nous estimons que, depuis 2023, l’AI Gateway a acheminé 986 milliards de tokens vers 12 fournisseurs et 3 clouds.
Nous avons également mis en place du caching, que ce soit pour les interactions directes avec les modèles ou pour celles avec les agents configurés sur la plateforme. Il nous permet de réaliser des économies substantielles qui, selon le type de modèle utilisé, peuvent atteindre 50 % de la facture finale. Nous disposons par ailleurs de passerelles qui peuvent bloquer les usages déviants d’un point de vue sécurité ou les réponses erronées d’un point de vue métier.
Un levier également très important est la construction d'un dashboard global qui permet de suivre les tendances à l'échelle du Groupe sur la consommation de tokens, le prix moyen du token en fonction du fournisseur, de l’entité, de la filiale et de la plateforme applicative qui consomme ces tokens. Grâce à ce dashboard, nous pouvons anticiper la consommation de tokens à deux mois, à trois mois, un an, voire deux ans, nous adapter et anticiper également les explosions tarifaires avant qu'elles ne s'imposent par elles-mêmes.
Comment gérer la croissance du nombre de tokens ?
Notre enjeu est de pouvoir consommer toujours plus de tokens sans faire exploser nos coûts. Dans cette perspective, nous recourons à de petits modèles de langage (SLM) chaque fois que cela est pertinent, avec un routage dynamique qui permet d’orienter un maximum d'interactions vers des SLM de type Mini ou Nano. En parallèle, les agents configurés sur la plateforme peuvent adresser en même temps plusieurs modèles de langage en fonction de la tâche effectuée par l'agent, et ainsi éviter d'avoir à utiliser un seul même modèle par agent. En intégrant ces nouveaux modèles en moins de 48 h en production à chaque fois qu'ils sortent, nous disposons ainsi d’un autre levier d'optimisation financière dans la mesure où ces SLM, pour une même tâche, consomment moins de tokens que des LLM classiques, et donc réduisent notre facture.
Comment arrivez-vous à maîtriser les agents IA ?
Nous avons ajouté une couche d'évaluation qui permet aux agents IA d’itérer avec un nombre réduit de boucles. Chaque agent IA doit passer ce test, qui mesure notamment le nombre de tokens en entrée, en sortie et en cache, le coût et la latence par tâche accomplie, ou encore le taux de régression en cas de changement de modèle cible.
À titre d’exemple, cette optimisation a permis à un agent de passer de 14 itérations et 210 tokens utilisés, à 6 itérations et seulement 70 tokens, soit une facture divisée par trois.
En parallèle, nous avons mis en place des conditions d'arrêt conditionnées qui vont permettre d'éviter à un agent de boucler sur une tâche impossible à réaliser avec les informations à sa disposition ou avec des instructions qu'on lui a fournies. En plus, lors des traitements de nuit, nous pouvons déclencher des alertes en cas de dépassement des quotas financiers au niveau de l’AI Gateway de la plateforme, ou également des quotas financiers au niveau de la consommation web de la plateforme. Un mécanisme d’amélioration continue ajuste le routage vers les modèles les plus pertinents au fur et à mesure que de nouveaux modèles sont activés sur la plateforme.
Enfin, chaque mois, un bilan est fait avec les parties prenantes, localement au sein des filiales, afin de leur permettre de suivre la consommation de leurs utilisateurs locaux et de partager un bilan des best practices auprès des utilisateurs de façon à obtenir un impact positif sur la consommation de tokens et la facture associée.
Quels conseils partager pour maîtriser l’explosion des coûts liés à l’IA ?
Chaque entreprise a évidemment ses spécificités, son histoire, et ses bonnes pratiques. Ce que nous avons mis en place chez Veolia peut être appliqué à des degrés divers.
Trois axes ont guidé notre démarche : voir, optimiser, gouverner.
- Voir, c’est identifier et caractériser chaque token. C’est la tâche principale de notre AI Gateway de les tracer. Le dashboard va visibiliser et ventiler les coûts quotidiens, Les traitements aux coûts atypiques sont détectés rapidement et stoppés automatiquement.
- Optimiser, c’est réduire le coût des réponses en multipliant les zones de cache, en mettant en production au plus vite de nouveaux modèles IA plus économiques, en favorisant les SLM lorsqu’ils suffisent.
- Gouverner, c’est maîtriser la demande, en fixant des quotas par utilisateur et par application, en réduisant le nombre d’itérations des agents IA et en partageant les bonnes idées avec l’ensemble des parties prenantes.
Autres articles sur le même thème
Par Jean-Louis DURIEZ